מודלים מקומיים מקצה לקצה: הקורס החדש שמריץ AI על המחשב שלנו, בלי שהמידע יוצא החוצה
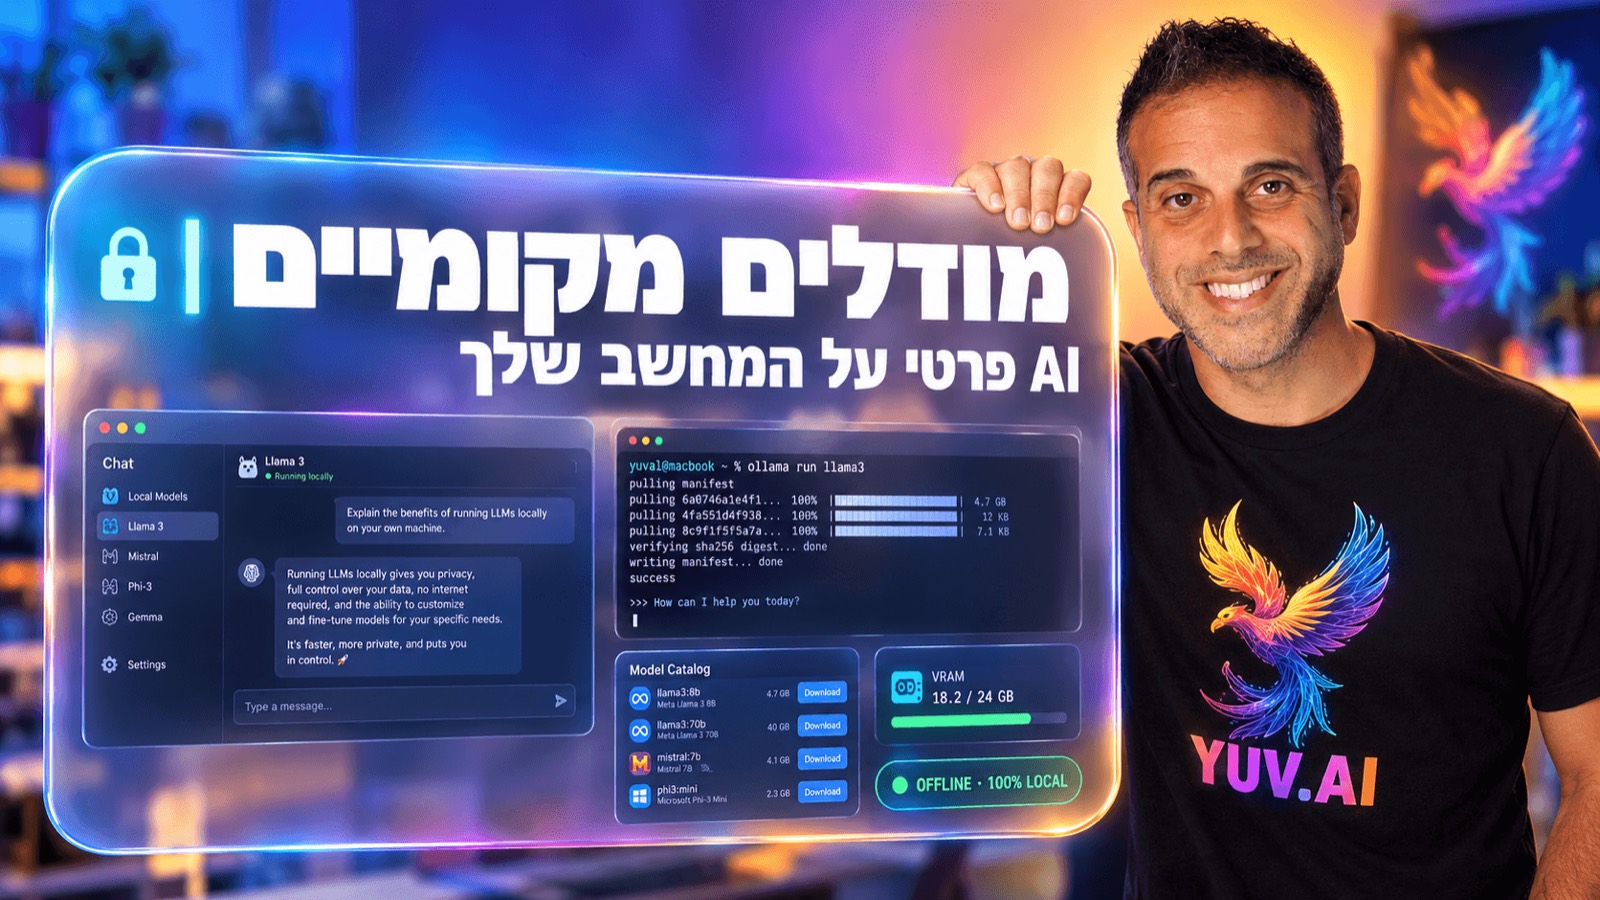
השקתי מיני קורס בעברית על הרצת מודלים מקומיים: LM Studio, Unsloth Desktop, Ollama ו-Hugging Face, מהיסודות של זיכרון כרטיס המסך ועד תמלול, יצירת תמונות ושיתוף המודל ברשת.
מודלים מקומיים מקצה לקצה, בעברית, ב-learn.yuv.ai/local-llms.
המודל רץ כולו על המחשב שלנו, בלי ענן ובלי חשבון, כך שאפשר לעבוד גם עם מידע רגיש.
מודל של 8B שוקל כ-4.9GB, מודל של 70B כבר 43GB. הקורס מלמד להתאים מודל לחומרה.
LM Studio, Unsloth Desktop, Ollama ו-Hugging Face, כולל תמלול, תמונות ושיתוף ברשת.
14 שיעורים, כמעט שעתיים של וידאו, 385 ש"ח.
הכתבה ב־5 שניות · נבנה עם HyperFrames
השקתי קורס חדש: "מודלים מקומיים מקצה לקצה", מיני קורס שמלמד איך להריץ AI על המחשב שלנו, בלי שאף מילה מהשיחה יוצאת החוצה. הוא כבר באוויר, בעברית, ב-learn.yuv.ai/local-llms.
למה דווקא עכשיו
כמעט כל שימוש שלנו ב-AI היום עובר דרך שרת של מישהו אחר. אנחנו מדביקים מסמך לצ'אט, והוא עובר לענן של החברה שמפעילה את המודל. לרוב זה בסדר גמור, אבל יש לא מעט מצבים שבהם זה בדיוק מה שאסור: חוזה של לקוח, תיק רפואי, קוד של החברה, מידע מסווג. ובמקביל אנחנו שומעים כל הזמן על דליפות של שיחות ועל מודלים שמגיעים למידע רגיש.
מודל מקומי הוא גישה אחרת. מודל מקומי הוא מודל שפה שרץ כולו על המחשב שלנו, עבור כל מי שרוצה AI בלי לשלוח את המידע לאף אחד. אין אינטרנט באמצע, אין שרת של חברה, ואין חשבון. תחשבו על זה כמו על ההבדל בין לשלוח מסמך לדפוס בעיר לבין מדפסת בבית: המדפסת אולי פחות חזקה, אבל הדף לא יוצא מהבית.
המכשול: הזיכרון של כרטיס המסך
מסתבר שהשאלה הראשונה היא לא "איזה מודל הכי טוב", אלא "איזה מודל נכנס אצלנו". מודל שפה הוא בעצם קובץ ענק של מספרים (משקלים), וכדי שירוץ מהר הוא צריך להיטען לזיכרון של כרטיס המסך, ה-VRAM (הזיכרון הייעודי של המעבד הגרפי, ה-GPU). במחשבי Mac עם שבב של Apple, הזיכרון הזה משותף עם זיכרון המחשב כולו.
בואו נראה את זה במספרים, לפי גודלי ההורדה הרשמיים בספריית Ollama:
גרף · נתונים מאומתים
כמה שוקל מודל: גודל ההורדה ב-Ollama
Llama 3.2 · 1B1.3GB
Llama 3.2 · 3B2GB
Llama 3.1 · 8B4.9GB
Llama 3.1 · 70B43GB
גודלי ההורדה הרשמיים (בגרסה הדחוסה ברירת המחדל) מספריית Ollama. זה המשקלים בלבד: חלון ההקשר דורש זיכרון נוסף. Llama 3.1 בגודל 405B שוקל 243GB, הרבה מעבר לכל מחשב ביתי. נכון ל־2026-10-19.
מודל של 8 מיליארד פרמטרים שוקל כ-4.9GB ונכנס בכיף ברוב המחשבים החזקים של היום, ומודל של 70 מיליארד כבר דורש 43GB. וזה עוד לפני חלון ההקשר (כמות הטקסט שהמודל "זוכר" באותה שיחה), שגם הוא תופס זיכרון, וגדל ככל שהשיחה ארוכה יותר. בקורס יש שיעור שלם רק על המתח הזה בין גודל חלון ההקשר לחומרה שיש לנו.
מה יש בקורס
הקורס בנוי מקצה לקצה, בידיים ועל המסך, ולא צריך שום רקע טכני מוקדם. מה שצריך: מחשב וסקרנות. 14 שיעורים בשבעה פרקים, וכמעט שעתיים של וידאו:
צעד אחר צעד
שבעת הפרקים
1
פתיחה ומבוא
מה זה בכלל מודל מקומי, איך הוא עובד, ולמה ה-VRAM קובע מה אפשר להריץ.
1 / 7
הקטע המדליק בעיניי הוא החלק של Unsloth Desktop. זו אפליקציה בקוד פתוח שיצאה באוגוסט, שמריצה מודלים של טקסט, תמונה, וידאו ואודיו לגמרי בלי אינטרנט, ואפילו מאמנת מודלים בלי לכתוב שורת קוד. בשיעור הבונוס אנחנו מתמללים קבצים, מייצרים תמונות ואודיו ובונים דאטה סטים (אוספי דוגמאות לאימון), הכל על המחשב שלנו.
איך זה נראה בפועל
כדי שיהיה ברור כמה זה קרוב, הנה ההתחלה של הפרק על Ollama, כלי שמריץ מודלים מהטרמינל (חלון הפקודות של המחשב). שתי פקודות, ויש לנו צ'אט עם מודל שרץ אצלנו:
המודל הראשון שלנו, בשתי פקודות
# 1. download a small model once (~2GB)
ollama pull llama3.2

# 2. chat with it - fully offline from here on
ollama run llama3.2
ומשם הדרך קצרה ליותר מזה: בפרק על LM Studio אנחנו הופכים את המודל לשירות שזמין לעוד מחשבים ברשת הביתית או המשרדית, עם ממשק שמדבר כמו ה-API של OpenAI. כל כלי שיודע לדבר עם ChatGPT יכול לדבר גם עם המודל שלנו, והמידע לא יוצא לאינטרנט.
בעיניי: למי זה מתאים, ומה לא
בעיניי זה הקורס שהייתי רוצה לקבל לפני שנתיים. הוא מתאים למי שעובד עם מידע רגיש ורוצה לעבוד עם AI בלי לחשוש, לחובבי AI שרוצים להבין מה קורה מתחת למכסה המנוע, ולמי שהתחיל עם ChatGPT או Claude ומרגיש שהגיע הזמן לשלב הבא.
וחשוב להגיד גם את המגבלות. מודל מקומי מוגבל בחומרה שלנו, ולכן ברוב המשימות הקשות הוא עדיין לא יגיע לרמה של המודלים הגדולים בענן. הוא כן מצוין לסיכום, לתמלול, לתשאול מסמכים ולעבודה יומיומית, ובמקומות שבהם הפרטיות חשובה יותר מהיכולת המקסימלית. בסוף הקורס נדע לבחור את המודל שמתאים לחומרה שלנו, להריץ אותו ולעבוד איתו בביטחון.